把「一句话问数」做成一套可校验、可留痕、可评测的工程系统。 自然语言不直接转 SQL,而是先转 Semantic IR —— 中间表示让语义可校验、可留痕、可复用, 下层不再重新解释上层已确定的东西。
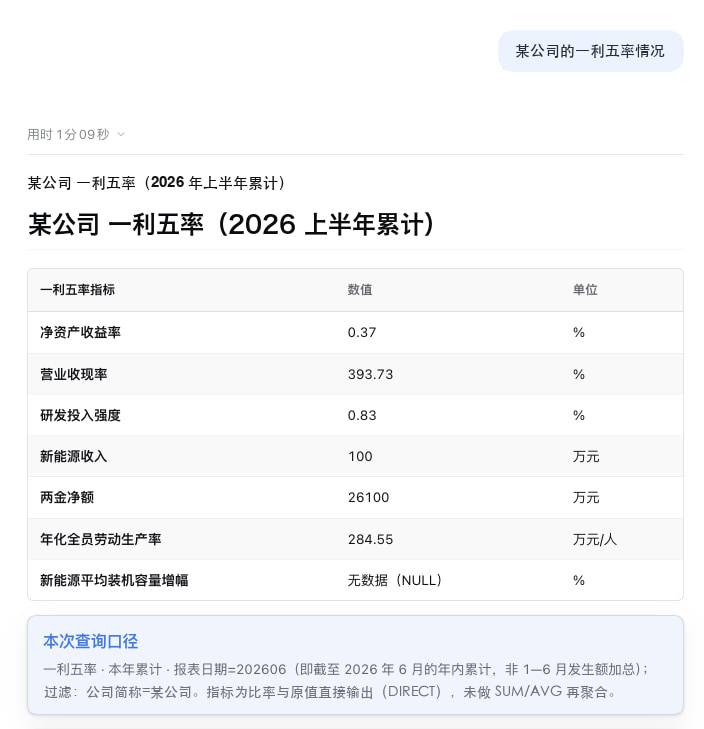
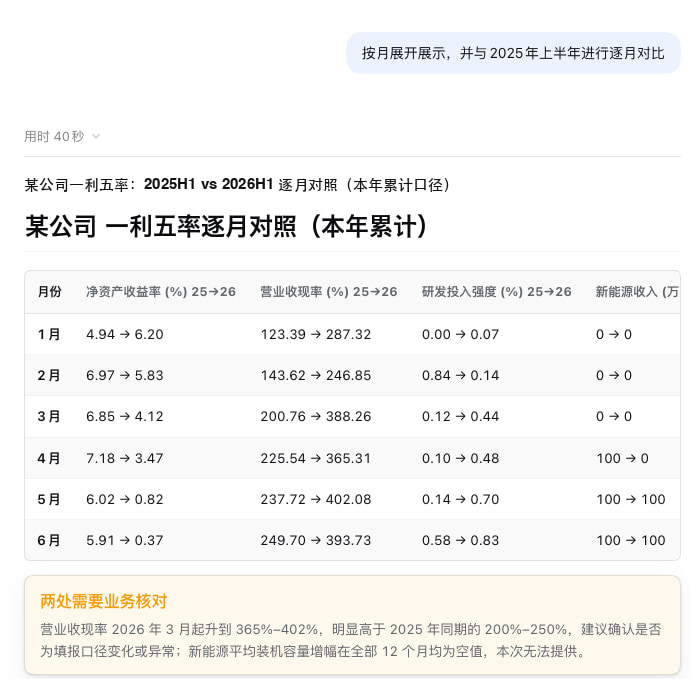
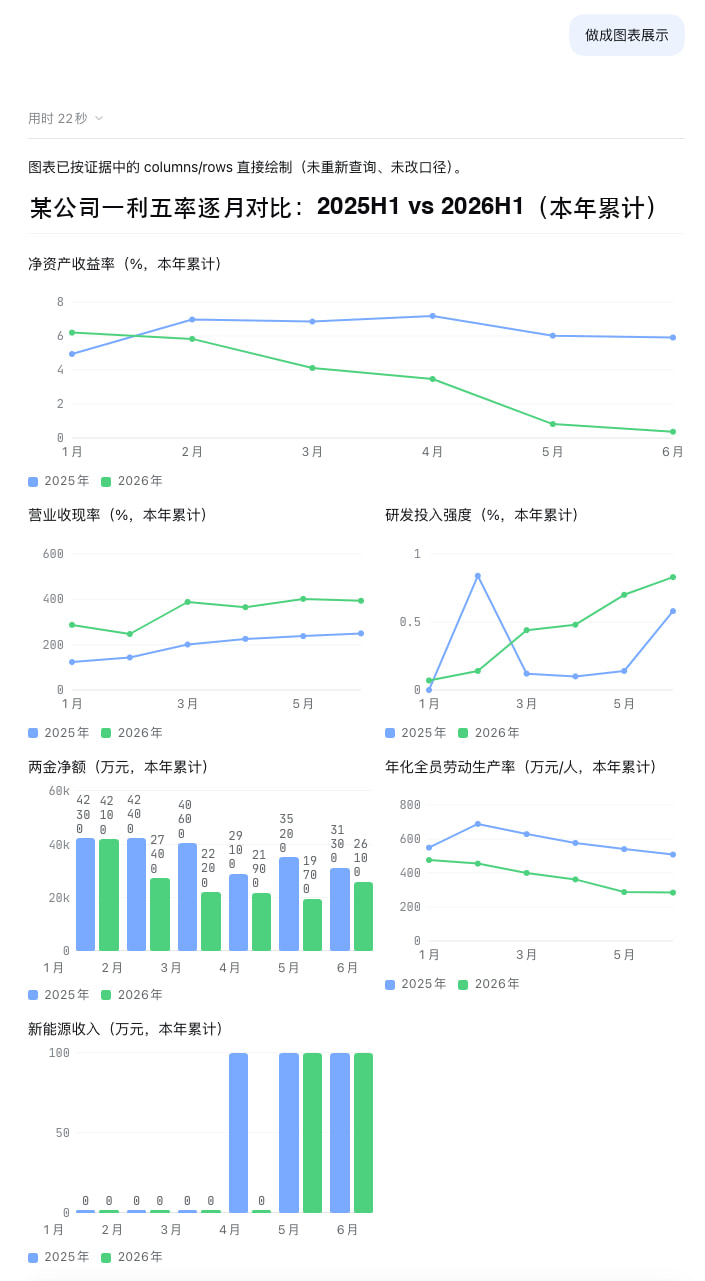
以下三段是同一个问题在实际系统中的连续三步,界面取自公司交付并上线运行的系统。 值得留意的是每一步都会交代「本次查询口径」——用了什么时间口径、过滤了谁、 哪些指标是直接输出、哪些地方数据不足需要人来核对。
数据库存的是一组字段,业务说的是另一套语言。这段空白靠提示词补不上—— 它需要一层被治理的语义定义,以及一套确定性的解析流程。
「销售额」是含税还是净额?是否只算已完成?同一个词在不同部门有不同算法。 口径是业务约定,不在 Schema 里——模型只能猜。
用户说「华东」,库里是 EAST_CHINA;
说「新能源车」,标准值是 NEW_ENERGY_VEHICLE。
映射关系不在 Schema 里。
一条 1,000 元的订单被 3 个订单商品复制成 3 行,SUM
得到 3,000。语法完全合法,业务结果差三倍——行膨胀不会报错。
能确定性检查的,不交给 LLM。 语法 · 结构 · 指标 · 关系 · 粒度 · 时间 · 权限 · 结果 —— 八类判断由程序执行,模型只负责理解、消歧与规划。
| 路线 | 语义由谁决定 | 口径可治理 | 失败模式 |
|---|---|---|---|
| 自然语言 → LLM → SQL | 每次重新决定 | 无 | 同一问题两次结果不同 |
| 解析后再让 LLM 写 SQL | 上层定、下层可推翻 | 部分 | 责任不清、口径被覆盖 |
| Semantic IR → 确定性编译 | 语义层一次确定 | 有归属、有版本 | 覆盖不足会缺指标,不会静默算错 |
建模顺序建议:先实体 / 维度 / 维度值(能被检索)→ 再指标(能被计算)→ 再关系(能被正确 Join)→ 最后补计算规则与访问策略。
实体与维度决定「按什么看」,维度值与别名决定「看到的到底是谁」, 指标决定「算什么」,关系决定「能不能安全地 Join」,计算规则决定「时间与口径怎么对齐」。
实体是业务上被讨论的主体,不是物理表:一张表是一份存储,一个实体可以对应多表、视图或分区; 表会随数仓重构变化,实体名应当稳定。维度分四类:枚举、层级、时间、高基数。
只存值是不够的:「华东」在订单、客户、仓库三处都存在,必须带所属实体、所属维度与维度中文名。 显示值与标准值分离,别名独立成表——可做唯一约束、可统计命中率、可为不同别名设权重。
区分度量、原子指标、派生指标与比率指标。指标表达业务公式,SQL 由编译器生成,方言只出现在渲染层。 比率指标声明分子分母,展开为 SUM(分子)/SUM(分母),禁止对行级比率求平均。
关系不仅是 Join 条件,它同时携带两个编译期约束:这条路径是否被允许、会不会改变聚合粒度。 只写 ON 条件、不声明基数的语义层,无法阻止 Fan-out。
同比口径、分摊规则、舍入与单位显式声明。时间口径是事故最集中处:期间流量与时点存量、 累计 YTD 与月度列、自然年与财年——缺失任一声明都会产生方向性错误。
拿不准的点写成 unknown_semantics 待澄清, 而不是静默降级成近似字段。一个判据:如果这份模型交给不了解数据库的人, 他能据此说清「华东一类客户新能源车销售额」该怎么算,模型就算合格。
| 防线 | 位置 | 检查内容 | 不通过时 |
|---|---|---|---|
| 指标粒度声明 | 语义模型 | Metric.grain 是否与事实表粒度一致 | 建模期拒绝发布 |
| 关系基数声明 | 语义模型 | Join 路径两侧基数是否明确 | 编译期拒绝生成 |
| Join 路径合法性 | 编译器 | 路径是否在关系图中存在且被允许 | 报错并提示候选路径 |
| 聚合安全性 | 编译器 / 校验层 | 放大比例是否影响最终指标口径 | 改写查询或提示换粒度 |
| 结果对账 | 结果校验层 | 与明细合计、其他路径结果是否一致 | 标注异常,不直接给结论 |
这是整个链路里不确定性最高的一段,因此更需要工程手段: 召回与精确分开追求,低置信度不硬选,澄清必须给出有界选项。
| 维度类型 | 典型基数 | 是否建维度值索引 | 检索方式 |
|---|---|---|---|
| 性别 / 状态 | 2 ~ 20 | 是 | Exact / Alias |
| 客户等级 / 地区 | 5 ~ 几百 | 是 | Exact / Alias / Keyword |
| 产品类别 | 几百 ~ 几千 | 是(分层) | Keyword 为主 |
| 客户名称 | 千万级 | 否 | 精确 / 前缀过滤 |
| 合同号 / 单据号 | 亿级 | 否 | 精确匹配 |
把全库值都做向量化,是典型的「用算力掩盖建模缺失」。 成本随基数线性增长,而召回质量并不会因此提高 —— 真正的收益来自别名表与层级结构。
不是把整张图交给模型。广度优先搜索在技术上可行、语义上不够—— 它会等权对待所有边,把上下文塞满与问题无关的节点。
| Intent | 典型问法 | 需要的算子 |
|---|---|---|
| Query 查询 | 华东销售额是多少 | 单指标单维度,可确定性执行 |
| Comparison 比较 | 华东与华南哪个高 | 对齐口径与区间 |
| Ranking 排名 | 各地区销售额排名 | RANK / TOP_N |
| Trend 趋势 | 最近 12 个月走势 | TREND + 时间粒度 |
| Composition 构成 | 各产品销售额占比 | SHARE + 合计窗 |
| Diagnostic 诊断 | 为什么下降 | 进入 Planner,开环分析 |
| Analytical 综合 | 经营质量怎么样 | 进入 Planner,多维评价 |
前五类可单次编译执行,后两类必须进入规划器 —— 这是「确定性执行」与「分析智能体」的分界线。
证据链已足以解释问题,不再继续消耗预算。
继续查的维度变化都在阈值内,再查只是消耗。
达到深度上限,防止概念链无限展开。
任务数、时长或模型调用达上限,保留证据链。
图谱中没有进一步诊断路径——此时应拒答,而不是硬编一个原因。
最危险的不是报错。语法错误会被立刻发现; 「SQL 正确、业务错误」不会——它表现为一个非常自信的错误数字。 因此校验必须分布在全链路,而不是最后做一次。
最重要的一条设计:上层已经把语义确定好了,下层不再有机会重新解释 —— 这是 Semantic Compiler 与「让 LLM 再写一次 SQL」的本质区别。
| 层 | 校验对象 | 检查内容 | 失败动作 |
|---|---|---|---|
| ① Syntax | SQL 文本 / AST | 能否被目标数据库解析 | 拒绝生成,报语法位置 |
| ② Schema | 表与字段 | 表存在、列存在、类型兼容、函数支持 | 拒绝执行 |
| ③ Semantic | IR ↔ Logical ↔ AST | 三者语义是否一致 | 回退重编译 |
| ④ Metric | 指标口径 | 是否使用了 Metric Graph 定义的计算方式 | 拒绝执行并提示正确算法 |
| ⑤ Relationship | Join 路径 | 路径是否被允许、基数是否正确、是否 Fan-out | 改写或拒绝 |
| ⑥ Grain | 聚合粒度 | 是否把不同粒度的数据错误聚合 | 拒绝或换粒度 |
| ⑦ Time | 时间语义 | 期间 / 时点、财年、同比区间对齐 | 修正区间或报错 |
| ⑧ Permission | 权限 | 行级与列级授权是否生效 | 改写为授权范围或拒绝 |
| ⑨ Result | 执行结果 | 合理性、量级、勾稽、交叉验证 | 标注异常,谨慎回答 |
同一个错误答案,可能是没召回、映射错、口径错、规划跑偏或结论越界。 分层评测让每一个错例都能定位到具体一层。
| 层 | 评测对象 | 核心指标 | 失败时的定位价值 |
|---|---|---|---|
| 01 | Mention 抽取 | Mention Recall / Precision | 区分「没抽到词」与「选错了对象」 |
| 02 | 语义检索 | Recall@K | 判断是检索漏召还是重排出错 |
| 03 | 实体 / 维度链接 | Linking Accuracy | 定位映射错误 |
| 04 | 指标解析 | Metric Resolution Accuracy | 定位口径选择错误 |
| 05 | 查询语义 | Operator Accuracy | 定位排名 / 同比等算子被漏掉 |
| 06 | 意图分类 | Intent Accuracy | 定位路由错误(该分析却单查) |
| 07 | Semantic IR | IR Exact Match / 语义等价 | 判断上层理解是否完整 |
| 08 | Planner | 路径合法率 / 证据覆盖率 / 无效查询率 | 判断分析策略优劣 |
| 09 | SQL | Execution Accuracy | 判断编译与执行 |
| 10 | 答案 | Groundedness / Abstention Accuracy / 幻觉率 | 判断结论是否有证据支撑 |
这一节不是案例包装,而是把每一层对应到真实数仓上:哪些地方按设计执行了, 哪些地方被真实数据推翻。范围决策先于建模——653 张表里排除 37 张 0 行空表, 排除理由与范围一起落盘,换人接手可复核。
| 档位 | 候选键构成 | 实测结果 |
|---|---|---|
| 第 1 档 | 全部业务键列(按基数升序) | 420 张首先通过 |
| 第 2 档 | 业务键列 + 业务时间列 | 多数宽表在此档通过 |
| 第 3 档 | 全部维度列 + 业务时间列 | 部分明细表在此档通过 |
| 第 4 档 | 全列组合(仅 ≤3,000 万行的表执行) | 229 张仍未证实 |
结构门禁 fail = 0,端到端冒烟却 0/8 全挂。 「声明自洽 ≠ 能跑」—— 这三个真实缺陷,是我们对交付质量的理解方式。
不会在没有数据的情况下编造数字,也不会拿旧结果凑另一个口径——两者不是同一口径、时间范围也对不上。 已把恢复后要跑的分析范围写清,等数据源恢复即执行。
Knowledge 说「可能查什么」,
Evidence 说「实际发生了什么」。 知识、规则、图谱、检索候选都不是证据,只有查询结果才是。
以下为语义链路演示,数值为示例数据;真实结果由受治理查询返回,并附带完整口径说明。
选择一句业务提问,观察它如何被翻译成结构化的语义中间表示,而不是直接拼成 SQL。
我们可以用你现有数仓的一小部分表做一次语义建模与端到端冒烟, 连同失败样本一起交付——包括那些我们没能算准的部分。